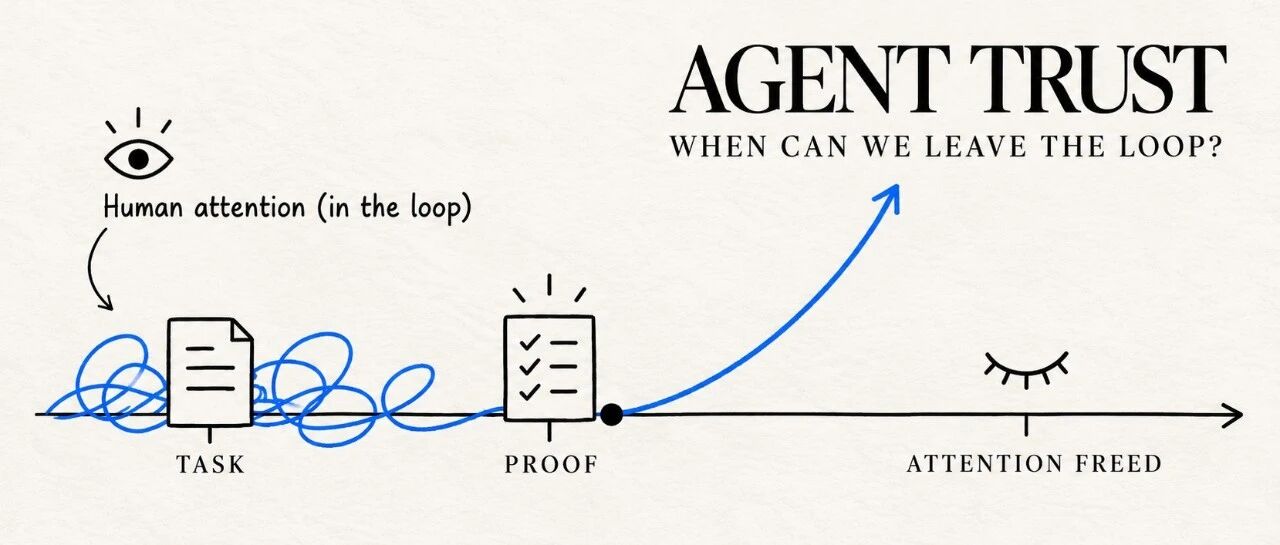
云端 Agent、独立沙箱、后台运行这些基础设施越来越成熟,Agent 也开始从一次性任务走向持续执行,多个 Agent 同时往下跑,Persistent Agent 的话题热度也持续上升。
按照这个逻辑,我们应该越来越敢把事情交出去。但真正用下来发现:
Agent能做得越来越久,不等于我敢越来越久不管它。
直到最近看到下面这个图,我突然觉得这个问题被说清楚了一点。
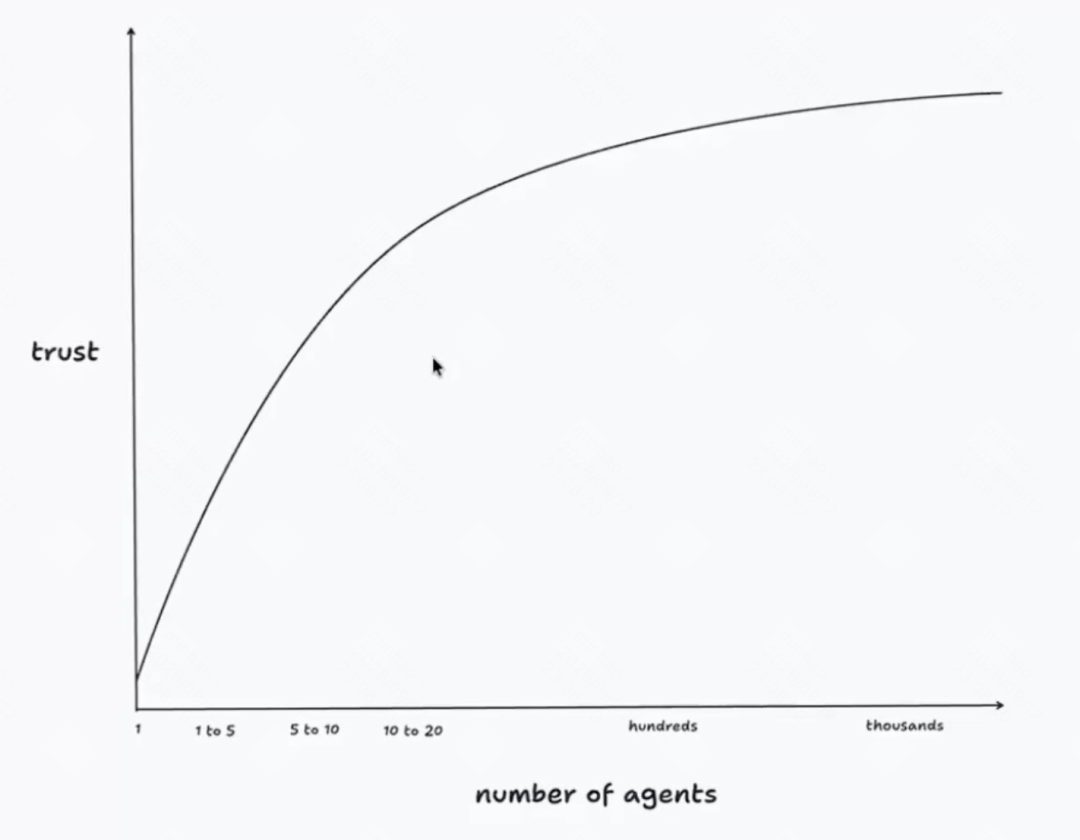
因为它讨论的不是任务有多长,也不是 Agent 有多少。
而是:Trust。
01
我们一直在量时间和数量,更应该量的却是 Trust
这张图来自 Lauren 上次分享她如何规模化管理 Agents。
它的起点其实很简单:
当 Agent 越来越多,我到底有多信任它们的产出?
以前看到她一个月上千、甚至两千个 PR,我最先注意到的是规模。
用了多少 Agent。
跑了多少并发。
做出了多少东西。
但现在再看,顺序可能刚好反过来。
数量不是起点。
先有一个小循环反复工作、接受检查,在明确边界里证明自己可靠,才有后面逐渐扩大的授权和并发。
所以这其实是两个完全不同的问题:
一个 Agent 能独立推进到什么程度,是能力问题。
我敢多久不看它,是信任问题。
低信任下,同时启动 20 个 Agent,并不会自动带来 20 倍产出。
更可能是突然收到 20 份等待验收的作业。
一个 Agent 连续运行三天,也不代表它真的接住了一件三天的工作。它也可能只是在无人察觉的角落,把最初的一点偏差放大了七十二个小时。
数量和时长,决定 Agent 理论上能做多少。
Trust,决定人实际上敢交出去多少。
02
工具链闭环了,我却还在屏幕前
我自己一直在摸索一AI 视频生产的一个链路。以前用 Claude,图片生成以后,我还要下载文件、告诉它路径,再继续下一步。
后来用 Codex,它可以直接调用 Image Generation,读取结果、放进项目、继续写代码和渲染。工具链终于串起来了。
照理说,我应该轻松很多。但真正看着它运行时,我还是在盯着。
第一张图风格对不对?人物前后镜头一致吗?它会不会把一张手部变形的图直接带进成片?这一轮该保留、重做,还是换方向?
我的手停了。注意力却没有离开。流程每走到一个路口,仍然会等我的判断。这就是隐藏在 Agent 外面的 Outer Loop。
很多所谓的自动化,只是清掉了人的操作。但只要“这算不算合格”仍然只存在于人脑里,人的注意力就始终拴在 Agent 身上。
任务越长、Agent 越多,这些判断断点就越容易堆积。
最后你会发现:
Agent 一直在跑,人一直在验收。
工具链闭环,只解决了机器怎样继续行动。
判断逻辑的闭环,才决定人能不能真正离开。
03
Trust 怎样被工程化
Lauren 在分享里直接问过一个问题:
How do I trust my agents more?
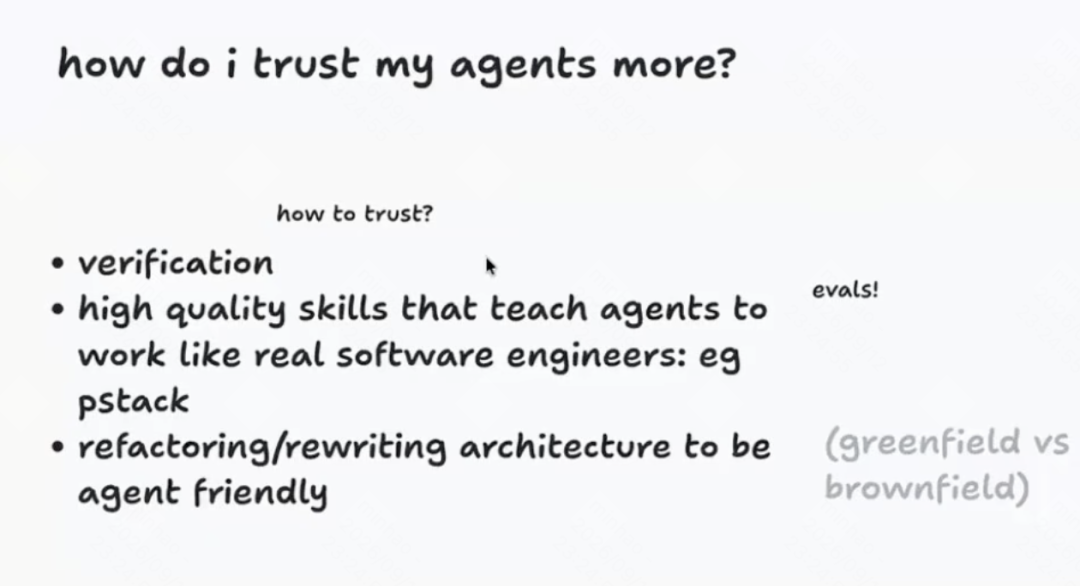
她给出的答案很工程化:
Verification、Evals、高质量 Skills,以及把原有架构改造成更 agent-friendly 的系统。
这也是我后来重新看 pstack 时,最有意思的地方。
它并不是在教人“多相信 Agent 一点”。
而是在试着回答一个更具体的问题:
如果人不一直盯着,Agent 靠什么知道该做什么、做到什么算完成,又怎么证明自己真的做对了?
Pstack 是 Lauren Lauren 把这套工作方法逐渐产品化的成果,在 Cursor可以直接使用的一个插件。最近一直在体验,非常丝滑。这基本就是她在确保 AI 产出标准化的产品沉淀了。
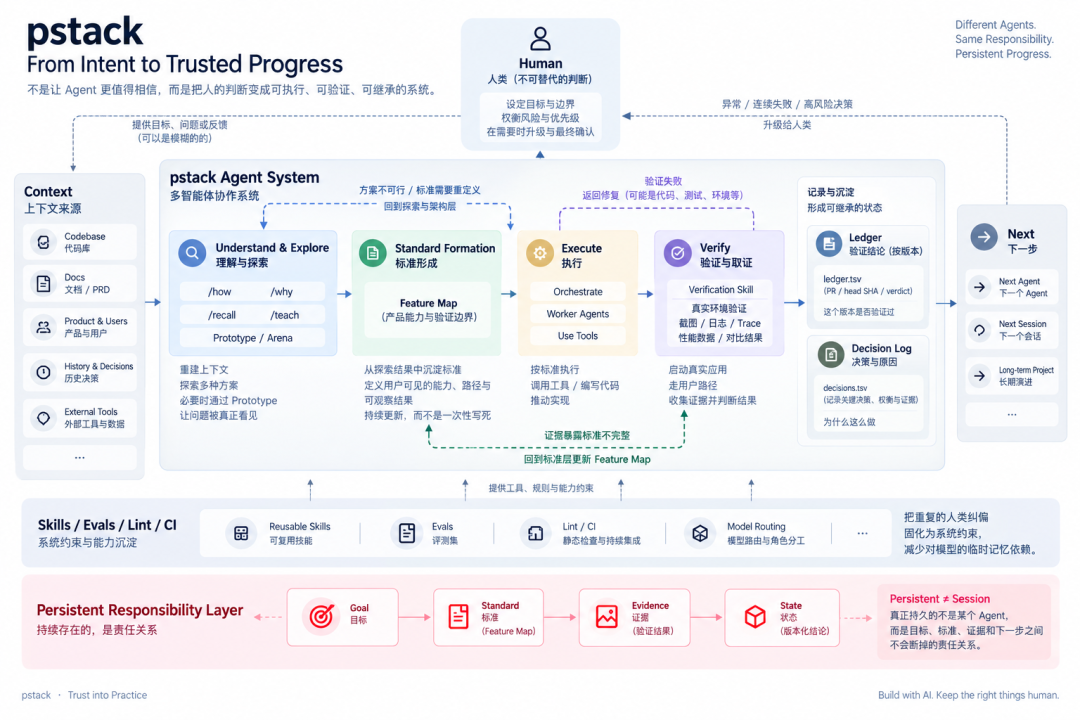
当然这个图也不需要每一个节点都需要搞清楚,最重要的还是用,如果是最核心的理念,我觉得有三个。
第一,先把“什么叫做好”搞清楚。
现实任务往往只有一个模糊意图。有些标准并不是人一开始就能写清楚,而是在方案真正跑起来以后,才逐渐暴露出来。
所以 Agent 不是直接开干,而是先重建上下文、探索方案,必要时做 Prototype。
然后这些判断再沉淀进 Feature Map,变成相对稳定的产品责任边界。
第二,做完不能靠自述,要靠证据。
Verification 要求 Agent 真正启动产品、走用户路径、看真实结果,再留下截图、日志、Trace 或性能数据。
所以 Feature Map 和 Verification 放在一起,本质上就是:
你要对什么负责。你拿什么证明。
“我做完了”,开始变成一种举证义务。
第三,这份判断还得能被下一轮接住。
pstack 会把验证 verdict 绑定到具体 PR 和 head SHA。
代码变了,旧结论就失效。
Decision Log 再保存关键判断、原因和证据指针。
这样换一个 Agent、换一个 session,系统留下的并不是一句“之前那个 Agent 很靠谱”,而是:
哪些标准成立过,哪些证据验证过哪个版本,现在什么还值得相信。
所以我现在更愿意把 Trust 理解成一种可交出的判断权。
它是:
在这段明确的责任范围里,它知道目标和标准,有办法举证,也知道什么时候旧结论已经失效。
这也是 pstack 最有价值的一点:
真正 persistent 的,是目标、标准、证据和下一步之间那条没有断掉的责任关系。
04
什么时候才真的可以放手?
写到这里,我反而觉得“长程 Agent”这件事可以换一个角度看。
云端、后台运行、多 Agent 并发,都在解决一件事:
怎么让机器继续工作。
但它们并没有自动解决另一件事:
人什么时候可以不再一直看着。
这也是为什么一个 Agent 能连续跑几个小时,并不一定真的帮你省下了几个小时。
如果每隔十分钟还要回来检查一次:有没有跑偏?结果能不能用?下一步是不是还得我判断?
那你其实只是从亲自干活,变成了远程监工。
真正发生变化的是人的角色。
如果能从:
每一步都要盯。
变成:
平时可以离开,遇到异常、风险和边界问题再回来。
这才是 Trust 真正开始的地方。
不是 Agent 永远不会犯错。
而是让你知道:
什么事情可以交出去,交到什么程度,什么时候系统应该把判断重新还给我。
所以现在再看“Agent 连续运行了多久”“同时启动了多少 Agent”这些数字,我会觉得它们当然重要,但还少了最后一步:
Agent 运行的时候,我的注意力能不能真的离开?
如果答案还是不能,那 Agent 跑得再久,也只是把人的 Outer Loop 拉得更长。
一旦答案开始变成可以,
Agent 才真正从一个需要持续照看的工具,变成了一段可以交出去的工作。
Agent 能跑多久当然重要。
但 Trust 真正兑现的那一刻,是它跑的时候,你终于可以放心离开。