这篇是对 Lauren Tan(@poteto) 那场 38 分钟分享的中英对照笔记。她现在在 SpaceXAI 做 Grok Bot。材料本该给 Cursor Compile London,她改在 X 上公开。
她开场的标题是:上个月往生产合进了 2500 个 PR。
论点不是多开 Agent,是先把厨房搭好
Lauren 说,她能做到这一点,很大程度靠的是信任:怎样才能信任自己的 agents,哪怕自己不在场,它们也能产出高质量的工作。
A lot of how I'm able to do this is through trust. And I think a lot about trust in terms of how I can trust my agents to produce high quality work, even when I'm not there.
今天这场演讲的论点是:如果你把 agents 的环境搭得非常好,最后会得到一种更像个人、甚至团队级软件工厂的东西。你可以比以前高得多的速度,产出高质量的代码。
If you set up your environment for your agents really well, you can end up with something that looks more like a personal or even team software factory, where you're producing very high quality code at a much greater rate than before.
米其林厨房,不是软件工厂流水线
她说自己其实不太喜欢「软件工厂」这个词。作为技术人员,他们并不是在流水线上量产一个产品。做的事情看起来很有创造性,是在做产品,某种意义上也是艺术。
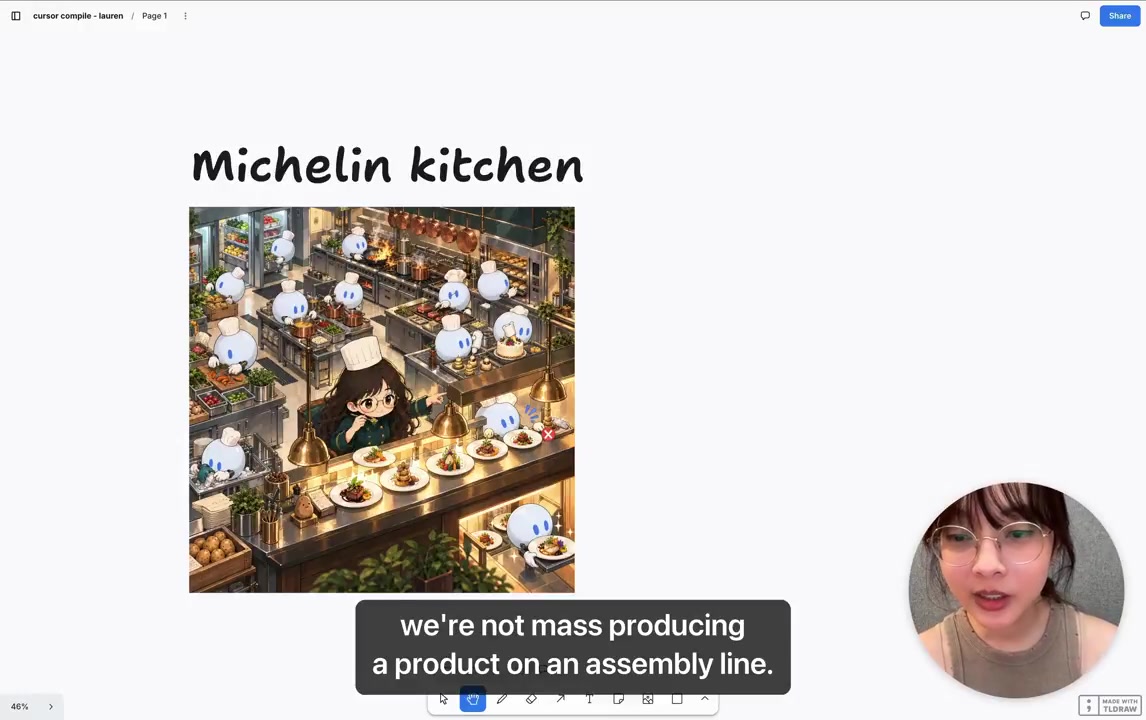
她更喜欢米其林厨房这个比喻。有了 agents,你不再亲自炒盘子里的每一个零件,但你仍然要对最终结果负责。你要想好厨房怎么布置:怎么安排配菜厨师、副厨,他们有什么样的设备和训练,洗碗工有多少、配菜厨师和洗碗工的比例。这些都会进入最终出品。
Even though with agents, we're not cooking the individual components that go into the product anymore. We're still responsible for the final outcome, and thinking about our kitchen setup.
她用自己六个月前加入 Cursor 的故事起头。那时还不是 SpaceXAI 的一部分,没有任何现成的 agent skills 可以用,面对的是全新的代码库和全新的产品。Cursor 正在做 Cursor IDE 的替代品,也就是新的 agent window。加入之前,这个窗口已经有不少性能问题。她刚从 React 团队过来,经理问她能不能帮忙。
上手很快意识到,这套流程有多手工。她当然做过性能工作。可是 PR 落地的速度太快了,感觉像一堵几乎翻不过去的墙,PR 还在不停涌进来。她完全不知道应用性能会不会在回归。
早期大量时间花在看 Chrome DevTools、做 performance traces、抓 heap snapshots。手工到她很烦,开始想:等一下,我们有 agents,我在干什么?
于是她开始想 verification skills:如果我的 agent 能自己跑应用、帮我抓 traces、读懂 traces、找到热点,是不是基本上就能自动 hill-climb,把应用性能往上推?
过去六个月真正垒起来的,是信任
她说,过去六个月在 Cursor 和 SpaceXAI,你能明显看到产出飙升。她从来没打榜一个月合 2500 个 PR,那根本不是目标。但她意识到,自己做的所有 skills、所有工具和代码库改动,最后都通向同一个东西:信任。
当时她还没完全意识到,但脑子里一直有一个想法:我才是瓶颈。我需要把我作为工程师的所有知识,灌进我的 agent 团队,这样我就不必成为每件事的卡点。效果很明显,这是值得的。
所以她觉得,根结底就是信任。但信任到底怎么建?不管你现在处在用 agents 的哪个阶段,应该从哪儿开始?
1 到 5 个 Agent 的阶段最难走出来
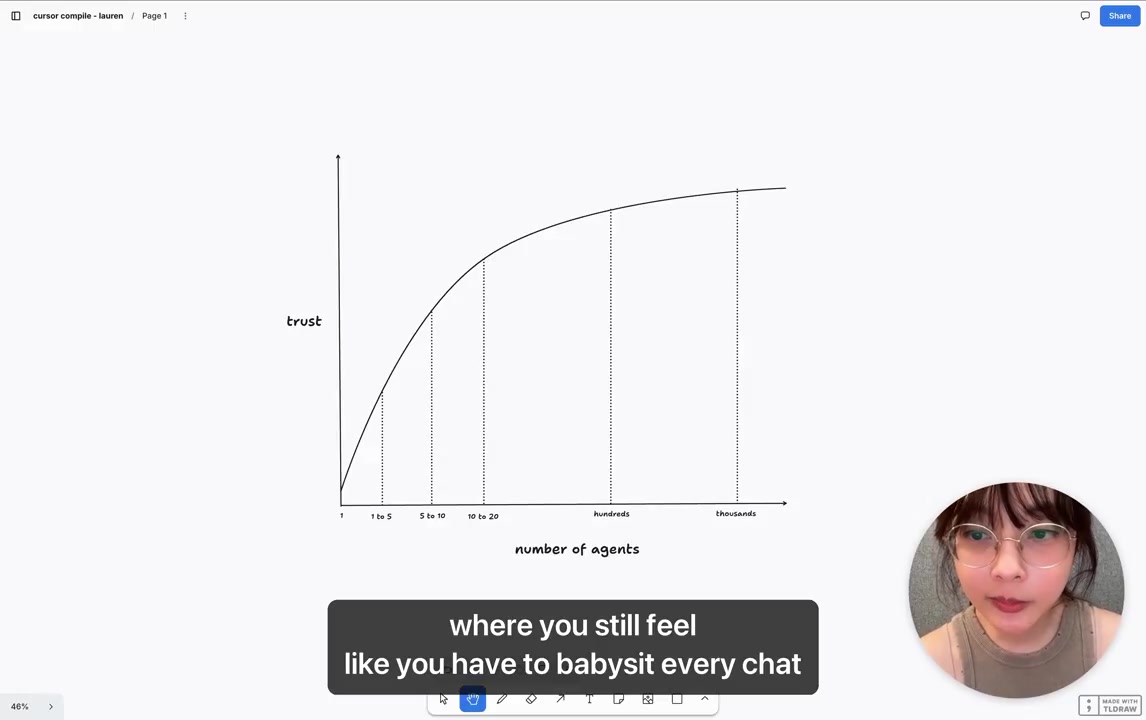
她刚开始显然处在这个档:1 到 5 个 agents 的范围。你还觉得必须盯着每一个 chat、每一次对话,不停地纠偏、介入,纠正 agent,让它做对的事。你不在场,基本上什么都不会发生,agents 还会做错。
她其实觉得,用 agents 的这个阶段是最难走出来的,因为你往往不清楚怎么走出来。说到最后还是信任。你没法从 1 个或 5 个 agents,扩到比如 100 个,是因为你还不信任它们的工作。
I would actually argue that this phase of using agents is actually the hardest to get out of, because it's not always very clear how exactly you get out of it. And again, it just comes down to trust.
如果你没有信任,却去拉起 100 个 agents 或 cloud agents,很快就会发现:一堆 slop PR、一堆回归、一堆 bug 被合进去。没人会高兴。那就引出一个问题:怎么才能信任你的 agents?
怎么更信任 agents:验证、skills、架构
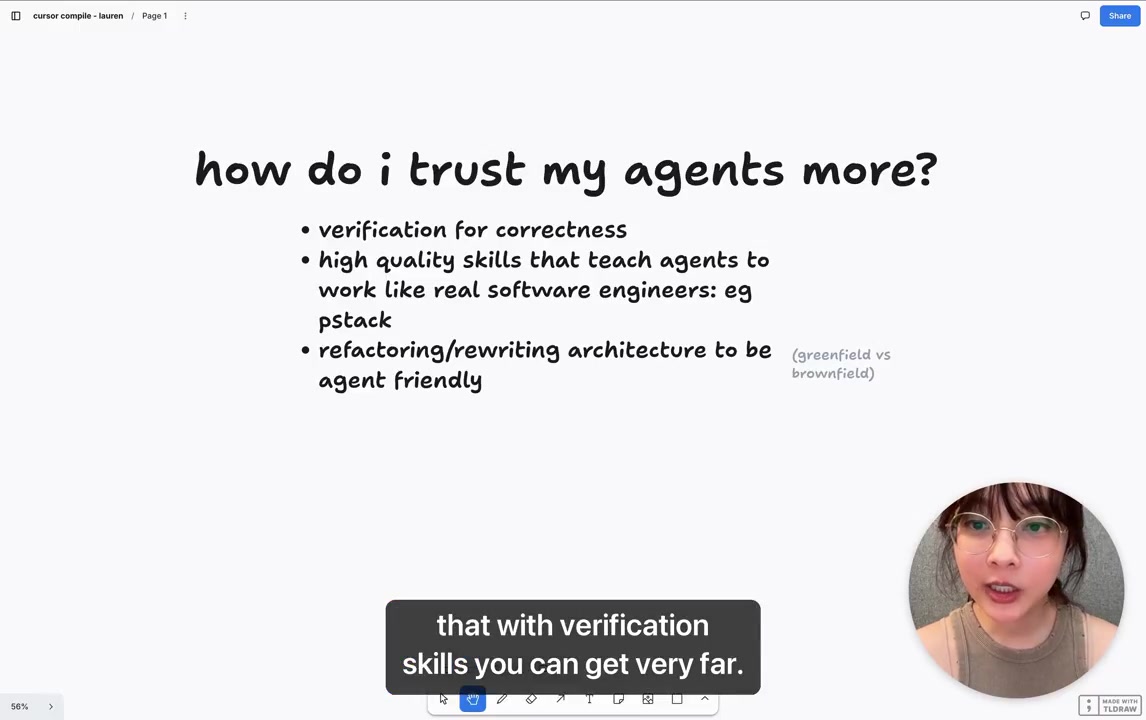
她把答案收成三件事:
- verification for correctness
- 高质量 skills,教 agents 像真正的软件工程师那样工作,比如 pstack
- 把架构重构、重写成 agent 友好
对她来说,真正开始是加入 Cursor 团队做性能的时候,她意识到需要 verification。她说的 verification 是有层次的。在比较低的一端,就是后面会讲的 verification skills:教 agent 怎么跑你的应用,怎么用 Chrome DevTools Protocol 或其他协议,教它们怎么 debug、抓 performance traces、抓 heap snapshots。
光谱的另一端难得多,也仍是开放问题:更正式的 formal verification。也许你会用 formal methods,或 Lean、TLA+ 这类语言去做验证,检查业务层或业务逻辑的不变量是否始终成立,从而形式化证明应用始终处于正确状态。
但她想说,就算你不会跑 formal methods,真正会的人很少,靠 verification skills 你也能走得很远。
ControlGlass:verification skill 的两半
她加入 Cursor、开始做 Cursor agent window 时,第一个 skill 叫 ControlGlass。它是一个 verification skill,教 agent 怎么跑起应用、抓 traces,通过 Chrome DevTools Protocol 来做。
这个 skill 有一个有意思的地方。她也是迭代出来的,一开始不是这样。control 或 verification skill 其实有两个部分。
第一部分显然是 CLI:你希望 agent 能可复现地跑起应用、收集 traces、收集经验证据,证明代码在工作、性能标准满足。与其让 agents 每次自己写脚本,不同 session 写出来不一样,你可以在 skill 目录里做一个 CLI,然后 agents 每次都用它。当然你得真正投入,把它做好,能覆盖各种用例,能正确把应用跑起来。
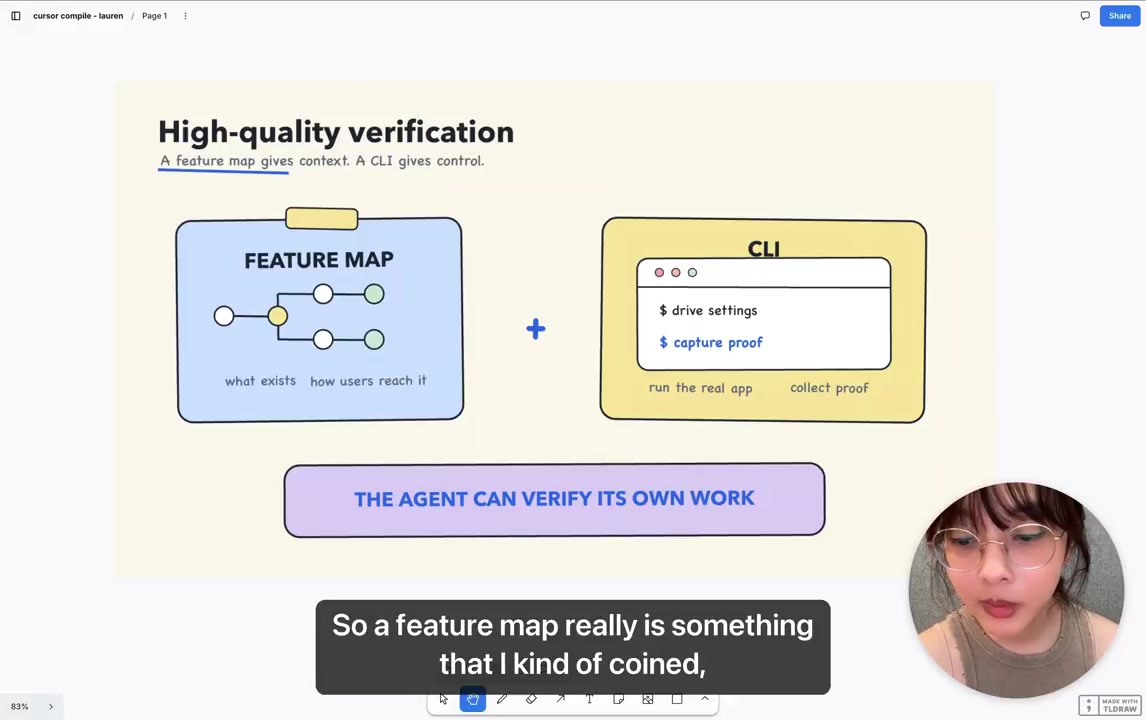
另一件她造的词是 feature map。开始在 Cursor 里用这些 control skills 之后,很快发现:Slack 上会来一封报障,用户贴一张很模糊的截图,UI 的一小块,再加三个问号。用他们 control skills 的 agents 完全没概念。它能跑起应用,但只能猜用户到底在说什么。
所以她有了做 feature map 的想法,有点受 sitemap 启发。它本质上是一种物化记忆:你的应用到底怎么工作?有哪些功能?用户怎么到达,快捷键、要点哪些 DOM 元素,以及各个功能分别做什么。
这个 feature map 存在 skill 本身里,作为代码库 skill 目录的一部分。他们也有自动化来维护它。把 CLI 和 feature map 合在一起之后,他们很快意识到这个组合非常强:agents 不但能可复现地控制应用、抓 traces,还能理解内部用户和外部用户提过来的需求。
他们很快意识到,这些 control / verification skills 太有用了,几乎成了团队的关键基础设施,他们一直在维护。agent 能自己验证自己的工作,这件事极强。他们在这个 skill 上花了很多时间,对建立信任非常、非常有帮助。
正确性之外,还要教 Agent 像工程师工作
verification 本质上讲的是正确性。对她来说,正确性就是:这个功能或这段代码,有没有做成你想让它做的事?结账按钮是不是真的把购物车结了?verification 对这个很重要,因为你能拿到经验证据,证明功能确实能用。但它几乎不告诉你这个功能的性能或代码质量怎么样。
这时候你就要开始想:有没有 skills 能教 agents 像真正的软件工程师那样工作。她做了一个插件叫 pstack。今天不会多讲这个插件,但它的很多灵感来自她自己做软件工程时,处理各种任务的工作流。debug、做功能、做原型,pstack 里带了很多不同的 playbooks 和 skills,教你的 agent 按你想要的方式写代码。
这正是团队里更有经验的工程师能真正贡献的地方:建一个团队共享的 skills 仓库,让你们的 agents 聪明很多。把这些 skills 和 verification skills 合在一起,agents 就不但能验证工作是正确的,还能验证它是高质量的。而且因为有 verification,你能收集真实的性能指标,拿到应用性能的真实数字、统计和 telemetry。她觉得这是很值得投入的一块。
纠正当下:代码库是最好的记忆
另一件她觉得非常关键的事,是把架构重构、重写成 agent 友好的样子。她几乎想说,这是一个软件工程团队能做的最重要的事情之一。因为如果你真的相信未来代码会由 agents 来写,那我们就必须把代码库设计成:默认就会做对的事。
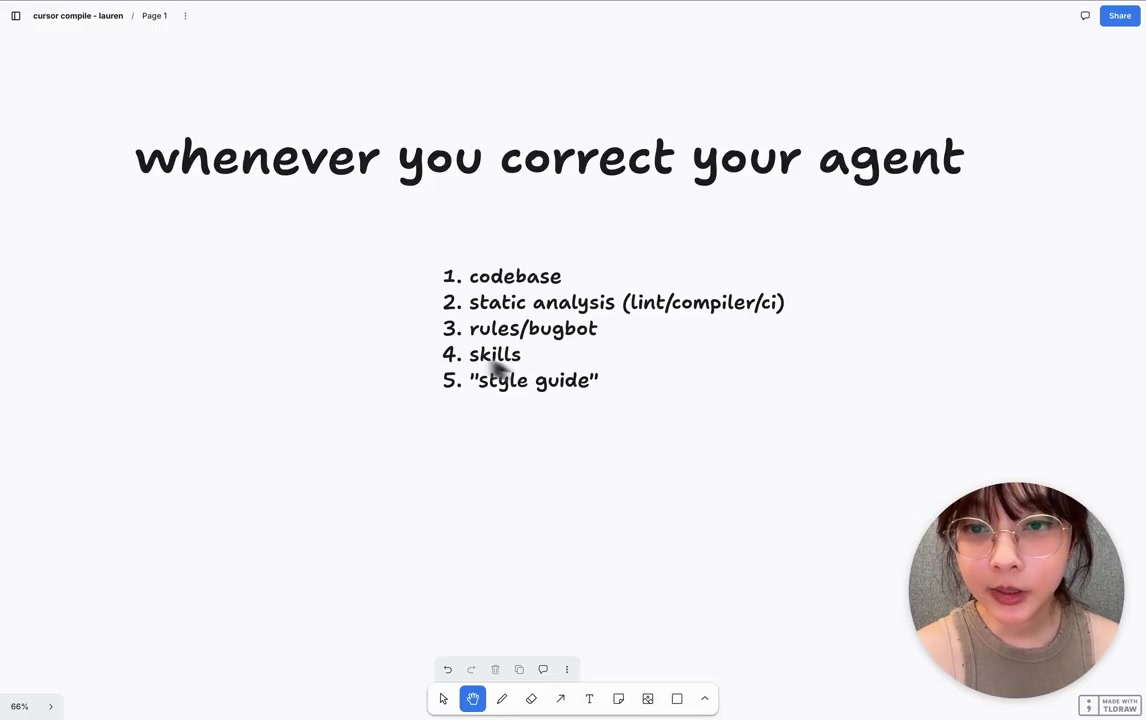
你会发现,建立对 agents 的信任,这些环节之间像有一个标尺或连续谱。她列了大概五点。代码库其实是最好的记忆形式,因为 agents 特别爱扩展它们看到的已有模式。
她觉得这就是 LLM 的本性:它们更倾向于用上下文窗口里已有的东西来做改动。agents 读到的文件当然也是上下文窗口的一部分。所以代码库非常关键。agents 不会在每一个 PR 里都重构你的代码,它们就是看有什么,然后往上延。
下一层是静态分析:linters、编译器诊断、CI。这些是你可以在代码库里强制执行的指南和约束。每当你纠正 agent,却发现它老犯同一个错,你就可以加成 lint rules。更好的做法是重构代码库,让它犯的那个错在类别上就变得不可能。
再往上一层,就开始从硬约束、强制执行,更多进入「引导」领域。比如 rules、bugbot、skills。agents 工作时显然会用到它们,但有可能因为各种原因忘了读某条 rule,或者开 agent 的人直接忽略。这些没那么能强制,但仍是把环境搭好、让你真正信任 agents 在做什么的重要部分。
最后是 style guide,基本上只能靠人在 code review 里执行。当然你也可以写进 rules、bugbot 和 skills。但如果你不这么做,review 流程就会有一个很大的窟窿:人必须盯每一行改动、还得记得评论。以现在 PR 进来的速度,这根本不可能。所以她绝对不建议只靠 style guide。
她觉得 style guide、或者看人的 review,作为发现「缺了什么」的起点是好的。但你真的应该花时间去想另外四块:代码库本身,用更好的数据结构或算法让错误在类别上不可能发生,静态分析,然后再叠上 rules、bugbot 和 skills。
Dune:为 Agent 设计的框架,捷径必须正确
在代码库一侧,Grok Bot 的代码库里,他们投入做了一个东西,叫 Dune,是面向 agent 的框架。Dune 的灵感其实就来自他们在 Cursor agent window 上看到的大量性能问题。
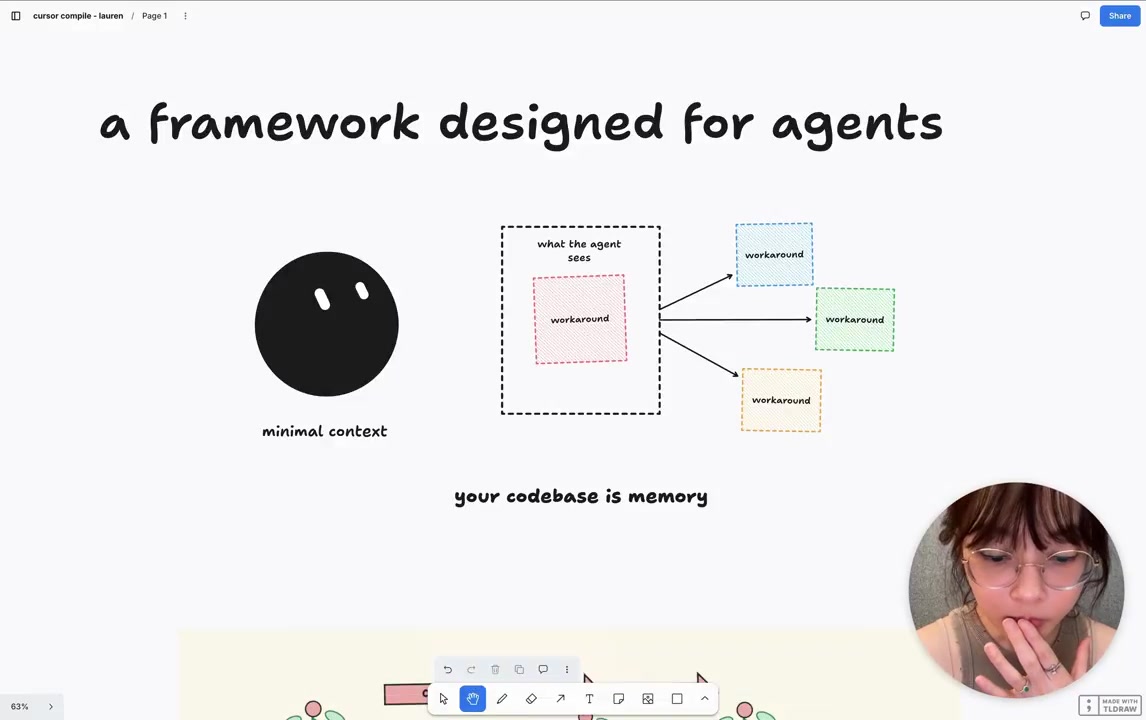
探索里出来很多教训,但核心原则是:agents 超爱走捷径。所以如果你设计一个框架,让捷径、好走的路,对 agents 来说就是正确的路呢?这样的代码库对人可能很烦,因为它对能做什么、不能做什么锁得很死。但这其实给 agents 创造了完美环境,尤其是上下文很少的那些,因为以后给代码库做贡献的,不再都是工程师了。
设计师、产品经理、CEO 都可能进代码库、上功能。所以他们真想:怎么投入、怎么建代码库,才能让那些很忙、上下文不多的人开着的 agents,默认也能干好。
代码库对 agents 来说就是一种记忆,因为它们爱扩展看到的已有模式。反过来也成立:你可以花时间把代码库搭成坏模式在类别上不可能出现,或者用 lint rules 挡住它们。
一个 workaround 会像病毒一样复制
反过来说也一样。如果你已有反模式,它们会像病毒一样扩散。一个小小的 workaround,或者一条解释 workaround 的注释,agents 超爱复制。几天、几周之后,这个 workaround 就到处都是,变成所有 agents 的既定模式。那是一个非常、非常糟糕的状态。
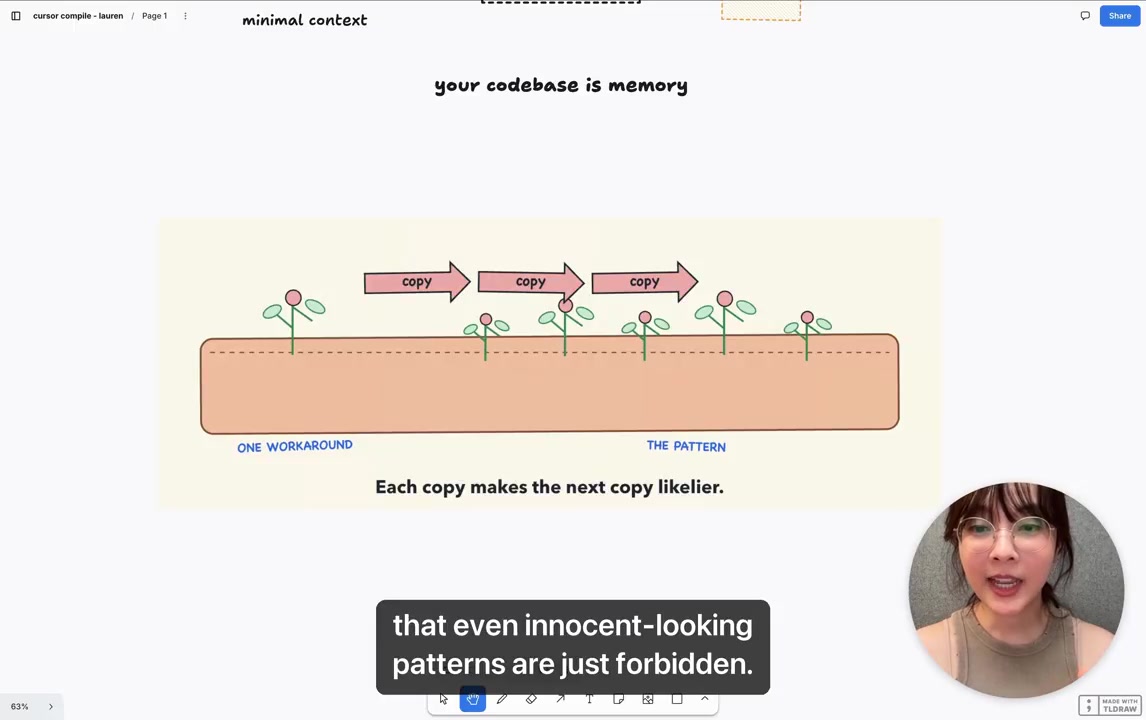
除了米其林厨房,她还喜欢另一个比喻:代码库有点像一座花园。那些 workaround 一开始看起来好像无伤大雅,但因为 agents 的本性,它们会一遍遍复制那个模式,很快你就会得到一个很 vibe coded 的代码库,维护起来要命,还有一堆性能问题。
所以在她看来,完美的 agent 代码库是锁得非常死的:对人写代码来说很烦,但它约定俗成、非常标准化,连看起来无辜的模式都被禁止。最好的例子,其实是一个乍一看非常、非常不想、细想却很糟糕的模式:agents 在代码里留注释。
她第一次看到 agents 开始这么干的时候,一开始觉得很多注释很啰嗦,但也觉得这好像也不是坏事。毕竟作为人类,我们看到边界情况、需要做 workaround,或者要给自己、给同事在特别绕的代码上留一句,也会写注释。
但他们在 Cursor 代码库看到这件事之后,很快意识到:agents 只是把代码周围的注释当成借口,解释自己为什么不去解决真正的问题,而是用创可贴或短期方案糊过去。所以在 Dune,还是那个驱动 Grok Bot 的框架里,他们选择直接禁止注释,免得 agents 复制这个模式、把它扩散到整个代码库。
每个团队都需要一个花匠
所以她的建议是:每个团队其实都需要一个她称为 gardener 的角色。就像真正的花园,你需要有人一直在想:哪些东西会悄悄长进来、往你不想要的方向长,还有其他有机生长。她其实不太懂园艺,但代码库里也会有不请自来的害虫之类的东西悄悄进来。你要尽早掐掉,别等它们扩散得到处都是。
Dune 背后的很多原则,其实就围着这三件事转。
第一,清掉已经有的 tech debt,原因就是刚才说的那些。
第二,对大多数「受祝福」的模式,我们要保持或强制一条铺好的路。有些事应该只有一种约定俗成的做法,这样 agents 不用猜。代码库、CI、lint rules 里要有足够引导,让 agents 走上这条路。
最后,每当你看到 tech debt 或坏模式,第一反应应该是:我要写一条 lint rule 挡住它。你不必立刻清干净,因为写了 lint rule 至少能止血。问题没有彻底解决,但至少不会再长大。所以她非常建议,认真想想怎么防反模式,别让它们像病毒一样传开。
然后也要花时间,真正让你的 agents 把它们清掉,让代码库一直处在这种状态:如果有 agent 来复制,你会觉得高兴。这就是她建议大家有的心态。
五个名词组织每个应用
她不会把 Dune 本身的细节全过一遍,只快过几个有意思的部分。再提醒一下:Dune 是他们为驱动 Grok Bot 做的架构、客户端框架。他们在她刚才说的事上投入很多,有很多约定:代码该住在哪儿,以及它们之间在哪儿、怎么互相 import。
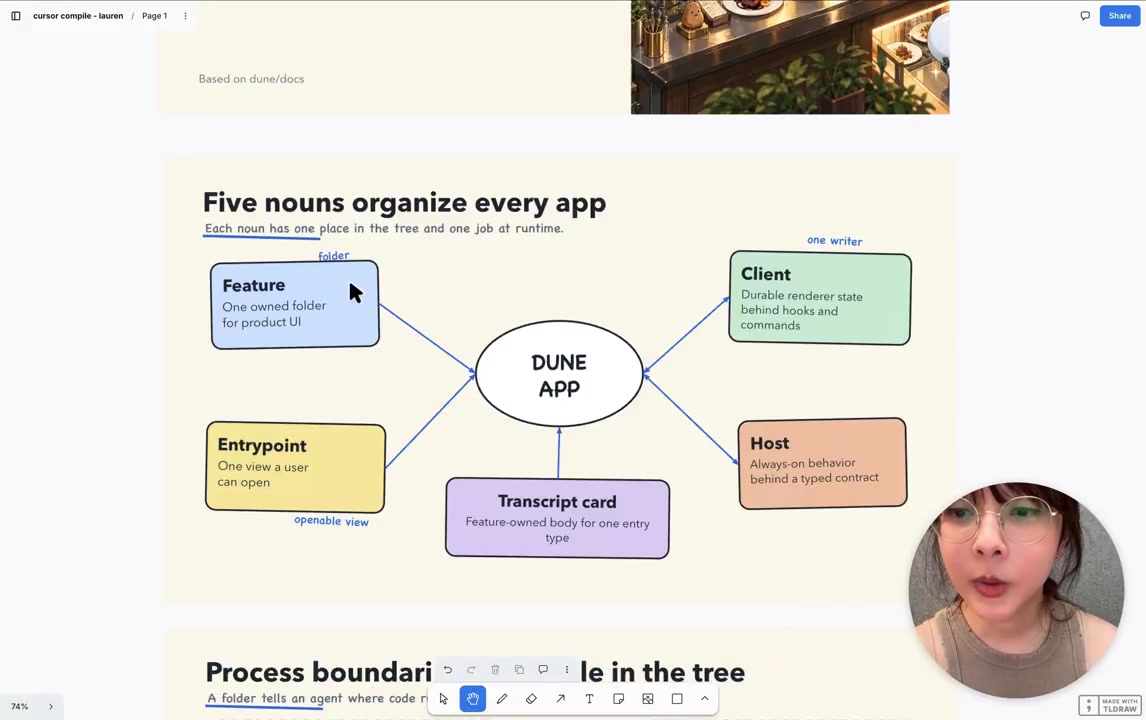
在 Dune 应用里有不同概念。比如 features 都共置在同一个文件夹。有一个入口,在 React 那一侧决定,你也可以把它想成一条 route。有 transcript cards,出现在 Grok Bot 应用里。有一个 host,跑在 Grok Bot 的虚拟机上。当然还有 client,驱动整个 Dune 应用。
这些东西之间有很多严格边界。举个例子:跑在 Electron 主进程或主线程上的东西,不允许跑到 renderer 线程上。他们故意保持这个隔离,因为从 Cursor 的 agent window 学到了教训。有时会看到代码被意外 import 进 renderer 线程,而且是慢代码。
而 renderer 线程上你希望 UI 非常丝滑、性能好。你必须确保没有 long tasks,也就是超过 16 毫秒的事,如果你要 60 帧;或者 8 毫秒,如果你要 120 帧。所以 renderer 必须一直处在能把工作切碎、而不一次做完的状态。
所以 Dune 里有代码,通过 import 和依赖图来强制这些边界。这只是一个例子:他们见过一种会导致性能很差的模式,然后通过 Dune 的架构,从类别上把它消灭了。
其他那些部分没那么有意思。核心主题其实不是 Dune 本身,而是:你们自己做一个 agent 友好的框架,其实非常、非常强。你可以把你和团队最好的工程师那些口口相传的经验,都编码进去。
从 style guide 里把知识抽出来
她觉得这里的教训是:怎么把这些东西,从以前靠 style guide、靠工程师互相 review 代码的流程里拿出来,下一步几乎就是把知识抽取出来,编码进框架、编码进代码库本身,让代码库充当记忆。
她总是回到这个想法:代码库就是你希望 agents 去延展的那个状态的物化快照。你希望这份代码库干净,干净到下一个过来的 agent 非常可能会继续这个模式,并把它保持得非常、非常好。
如果你在这个过程上花够时间,就像她提到的,你真的能搭起一座米其林厨房,或者软件工厂。因为你在所有这些让你能信任 agents 的环节上花了很多时间:代码库、lint rules、诊断、rules、bugbot、skills。这些层叠在一起,会给你很多信任。
现在想象一下,你在 Grok Bot 代码库里工作。它锁得非常死,几乎不可能写出坏代码。所以哪怕一个上下文很少的 agent,哪怕推理能力不强的 agent,进来也能写出好代码。
外环:Grok Bot、cloud agents 和自动化
回到米其林厨房的例子,这里面东西很多。他们在给 agents、bots 配 skills 和工具,在训练它们,在把厨房布置成:agents 和 bots 默认就会做对的事。
比方说在厨房里,如果他们注意到某个厨师或洗碗工老是被什么东西绊倒,当然要修。他们要解决问题,确保别人也不会绊倒,因为厨房是个很危险的地方,你不想伤到自己。她觉得对代码库也应该是同样的心态:怎么把它搭好,让哪怕知识不多的 agents 也能干好?
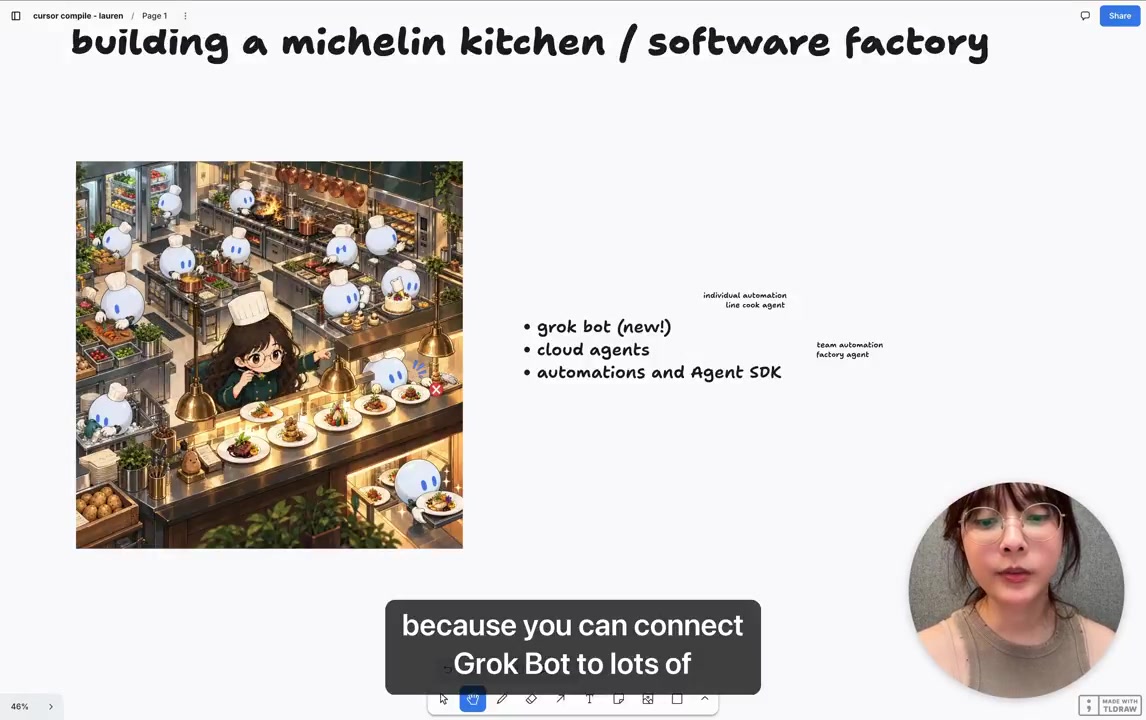
她觉得 Grok Bot 和 Cursor 放在一起有一个很有意思的角色分工。Grok Bot 特别擅长提供她所说的 outer loop:你可以把 Grok Bot 接到各种 connectors,比如 Slack、Datadog、Sentry、PlanetScale,你在用的任何服务,把这些信息叠起来,用它给自己做很好的决策。
有人把这叫公司大脑。她个人觉得不需要那么复杂,因为 agents 很擅长用工具。所以如果你把这些工具接到 Grok Bot,再让你的 Grok Bots 自动拉起 cloud agents 这类东西,你会发现:其实不必砸很多基础设施,也能搭一个软件工厂。
其实她要把这个词划掉,因为她不喜欢这个词。她觉得你完全可以自己搭一座个人米其林厨房,比如用 Grok Bot routines:订阅 Slack 线程、Sentry 告警,自动把事情踢起来。
把她一直在说的这些,代码库、rules、skills,合在一起,它们会复利。Grok Bot 就能自动响应来自 outer loop 的事件,然后拉起 cloud agents。你也可以设 Cursor automations,用你们的 SDK 再搭更多 bots,复用你已经搭好的这些 agent 基础设施,让它去做更复杂的任务。
如果你这些都做了,她觉得就能到这个程度。他们有一些 automations,以及在 Cursor 上工作的 agents:他们在自动复现 bug reports,自动开 pull requests,本质上是给整个团队加很多价值,因为这些都会复利。
如果只带走一件事
再拉远一点,回到这张图。作为收尾:如果你花很多时间去想,要爬上这张信任图需要哪些环节,你就会走到一个地方。你能更信任你的 agents,能并行你的工作,也能赋能整个团队,让大家站在这些 agent 基础设施之上,让每个工程师、每个 builder 都极其高效,并能写出高质量代码。
最后想留给大家的其实是这一块。抱歉,不是那一块,是这一块。如果这场演讲你只带走一件事,就应该是这页:这些活动能帮你堆出一个高信任环境。每当你发现自己在纠正、介入你的 agent,你真的应该从这五块来想,在这条序列里哪一步最有效,能让你的 agent 更值得信任。
她非常建议按这个顺序来想。要么花时间,通过代码库、架构和数据结构,让那个模式在类别上不可能发生。要么从静态分析入手,再叠上 rules、bugbot 和 skills。
如果你这些都做了,并且也花时间从 skills 的角度去想代码质量,你就会信任这个环境到这种程度:你的 agents 可以直接放开跑。就她个人来说,比如在 Grok Bot 的代码库上,她就在这上花了很多时间。这其实是秘密。好吧,也不算不上秘密,就是很多苦活。
希望这场演讲对你有用。欢迎在 X 上找她,handle 是 poteto,中间是 e。希望你们搭建自己的米其林厨房时,又好玩又成功。