Grok Bot 到底有没有大规模火起来?好像是个未知数,虽然我自己个人也持续在玩。
但最近看 Grok 的工程师 Lauren Tan 分享她调度 Grok bot + 云 Agent 的方式,确实是很干的干货。
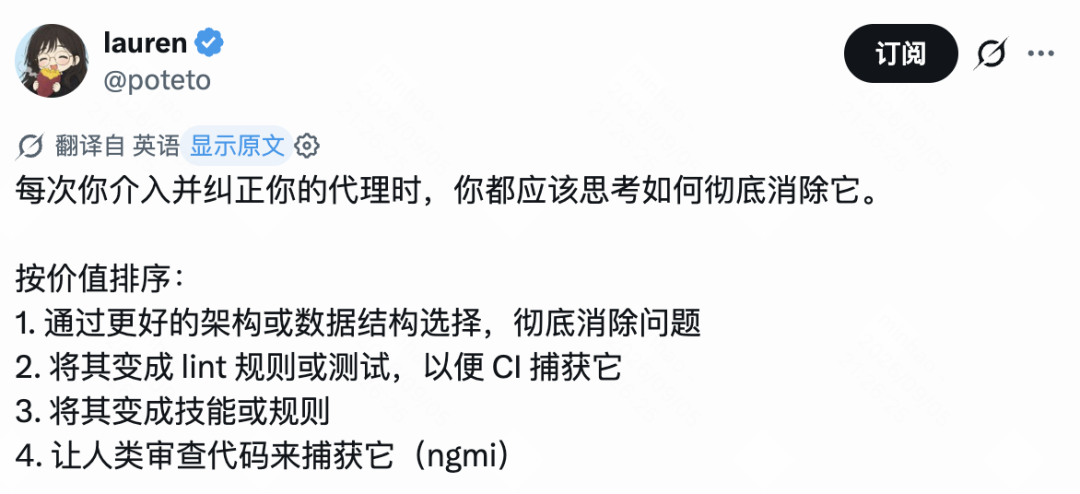
前阵子她发过一条关于 PotetoMode 的思考,核心意思很硬:每次你发现自己需要介入纠偏 Agent,都应该想想怎么靠架构、Lint 或测试把它彻底消除,别总在 Prompt 里当保姆。
真正让我顺着她开源的 pstack 一路挖下去的,是她背后惊人的工程吞吐量:Lauren 目前在 SpaceXAI 参与 Grok Bot 和 Cursor 的工作,同时也是 React Core team 成员。
按她公开的数据,她个人靠这套系统每月合入2,000 个 PR,而 Grok Bot 整个团队每天有数百个 PR在进入同一个代码库。
比起这些夸张的数字,更值得看的是:这些代码到底是怎么被生产出来的。
01 她根本没在用一个“聊天机器人”
如果去看她最近公开出来的 prompt、playbook 和工作方式,最先冲击我的不是那些 Prompt 技巧。
而是她人和 Agent 之间的站位已经变了:
Lauren ↓ Grok Bot / Coordinator ↓ ├─ Cloud Agent A ├─ Cloud Agent B ├─ Cloud Agent C └─ Swarm
她自己不再守着每一个 worker,一轮一轮地聊。
在这个结构里,前台的 Grok Bot 或者本地会话,更多扮演一个 Coordinator。
在她为长期项目写的 orchestrate 文档里,有一句原则写得很直接:
Coordinator 负责整个 program,但不亲自写代码。
它更关注的是:
把大目标拆成一份份自包含的 Brief;
把任务派发给独立的云端环境;
收回结果,检查验证证据;
判断下一步是继续、打回还是合并。
真正执行具体任务的是下面的 Cloud Agent。
但这些 Cloud Agent 也不是一次性的单轮函数。每一个 Agent 拿到独立环境后,自己内部仍然可以跑完整的多轮闭环:
改动代码 ↓ 驱动应用验证 ↓ 失败 ↓ 看证据再改 ↓ 通过验证 ↓ 交出证据和产物
所以这里有一个特别容易误解的地方:
Lauren 不是从“一个 Agent”变成了“一堆一次性 Agent”。而是把两类工作拆开了:
长期身份放在协调层,具体执行交给一批彼此独立的 worker。
02 Agent 可以换,工作的标准不能换
看到这里,我当时最大的疑问是:
如果下面这些 Agent 都是独立拉起来的,并发一多,它们不会各干各的吗?
相比反复调教某一个 Agent,她明显把更多精力放到了闭环基础设施上。
任何一个 Cloud Agent 被拉起来,不管它最终用的是哪个模型,都可以拿到两类很重要的东西:
第一类是Feature Map。它不是一篇给人看的宏大架构文档,更像是一份从真实用户路径出发的功能索引:这个功能在哪里、用户怎么进入、需要什么前置状态、验证的时候应该去哪里看。Agent 不需要每次重新把整个代码库读一遍,才能知道自己现在处理的功能到底处在哪个位置。
第二类是Verification Skill。这也是她反复讲的 “Build the Lever”。比如给 Agent 一个可以真正控制应用的工具(类似 /control-app),让它可以操作真实界面、模拟输入、读取 DOM、截图、抓 trace。
Feature Map 和 Verification Skill 合起来就是一种标准。
它不属于某一场对话。一个本地 Agent 可以用,一个 Cloud Agent 可以用,几十个 worker 也可以同时遵守。
于是一个修 Bug 的 Agent,不再只是汇报一句“我改完了”,而是必须:先真正把 Bug 复现出来,改代码,再重新操作一遍产品,确认现象消失,最后交出截图、trace 或其他验证证据。
而且是自动对齐标准。
03 工人退出了,工作却还在
顺着这个逻辑再往上看,我才突然注意到另外一件事情。
底层一次具体执行当然可以结束。一个 Agent 做完任务以后,这段执行可以退出;走进死胡同,也可以放弃当前上下文,重新派一个新的 Agent。
但是:
Worker 退出之后,工作状态并没有一起消失。
PR 还在,branch 还在,commit 还在,验证结果还在。不管是当前的还是重新启动的 Coordinator,都可以重新依据这些外部状态接续工作。
甚至在她的 orchestrate 体系里,还有一份跟 PR 维护的验证账本:ledger.tsv。
里面的验证结论(比如 live-ui-verified 或是 unit-test-verified),会直接跟PR 编号 + 具体 head SHA绑定。代码变了,SHA 变了,原来的验证结果也就不再自动成立,需要重新验证。
需要持久化的,不只是“Agent 记得什么”。还有工作现在处于什么状态,以及:一份证据到底对哪个版本仍然有效。
看到这里,我才第一次认真觉得:
Agent 能一直干,和一件事一直归它管,是两回事。
前者大家都很熟悉,但是后者其实很多人还没什么概念。
04 重新理解 Persistent Agent
过去这一两年,只要看到长程 Agent、自主 Agent,我最容易兴奋的其实都是:它这一轮到底能跑多久。
用 Manus 的时候,我第一次很明显地感觉到:一个任务交出去以后,十几二十分钟都不需要我的下一句话。后来又开始研究各种 loop,只要目标没完成,就继续做。再后来看到一些 CRM Agent:今天判断“不该联系”,先等,过几天再醒来。
这些探索当然都很重要。但 Lauren 最近这套工作方式,让我开始想把两个问题拆开:
Continuous Execution 是这一轮能自己干多久?
Continuous Responsibility是这一轮结束以后,甚至当前执行者已经退出以后,这件事是不是还归它管?
一个更接近执行能力,另一个更接近责任与系统结构。
而 Lauren 在 orchestrate 文档开头的一句话,正好戳中了这个区别:
Route here when the work outlives any single agent.
(当一项工作的生命周期,已经超过任何一个单独 Agent 的寿命时,再进入这套模式。)
我以前很自然地把 Persistence 想成:让一个 Agent 活得更久。更大的 Context、更好的 Memory、更复杂的长短期记忆,尽量让同一个 Agent 不要忘。
但 Lauren 这套东西至少给了另外一种想象:
执行 Agent,不一定非得和责任拥有者是同一个东西。
一次会话可以结束,一个 worker 可以退出。但目标、工作状态、验证标准,以及下一步要依据的证据,可以留在系统里。
这时候 Persistence 就不再只是:怎么让一个脑子活得更久。
而开始变成:一项工作怎么活得比某一个 Agent 更久。
05 一轮结束以后呢?
看到这里,我其实还没有得出一个完整的 Persistent Agent 架构。
到底哪些东西应该长期存在?Coordinator 应该保留多少状态?Worker 什么时候继续用,什么时候应该重新拉一个?这些问题我自己都还没有真正跑明白。
但有一件事已经变了。
过去我很容易用“一轮任务”的表现判断 Agent:能不能少找我几次、能不能自己多跑几轮、能不能自己发现错误再修、能不能把一个原本需要十轮对话的任务一次推进到底。
这些能力我现在依然在意。但回过头看自己平时真正使用 Agent 的方式,会发现一次任务结束以后,很多事情其实又重新回到了我身上:
还是我记得这个项目下一步有什么。还是我发现新的反馈。还是我判断现在是不是应该继续。还是我重新找一个 Agent,把前面的事情重新交代一遍。
今天很多 Agent 看起来已经很自主了,但那个真正 persistent 的东西,其实还是人。
所以我现在开始觉得:
长程解决的是:这一轮能走多远。而 Persistent 真正让我感兴趣的问题可能是:这一轮结束以后,工作还能不能继续存在。
我现在还不知道 Lauren 这套模式是不是 Persistent Agent 最终的样子。
但以后再判断一个 Agent 是否真的开始像一个“长期工作的角色”,我大概会多问一个以前很少问的问题:
今天我把一件事交给它。
三天以后,这件事还归它管吗?